接口集群接入:支持标准 OpenAI SDK 调用,提供极具性价比的高并发企业级模型接口,助力开发者无缝嵌入智能应用。
查阅开放平台文档
↗
01
板书第 01 讲:纯强化学习大模型的自我涌现与探索
打破传统监督学习枷锁
在纯强化学习中探索未至之境
欢迎访问 DeepSeek官网。深度求索通过首创的纯强化学习(Pure RL)与大规模冷启动自省演练,使大模型无需海量人工标注即可自主涌现反思验证、逻辑纠错与长思维链能力,全面革新数学竞赛、高难度代码与综合推演的生产力上限。
[CHOKE POINT // 极简交互入口]
DeepSeek网页版入口
免登录极速体验 DeepSeek-R1 满血长思维链自我推演与代码沙盒。
FIG. 01 教学手绘板书与思维链示意
数理逻辑硬核评测 · 板书记录
✎ 标红高亮为官方 DeepSeek-R1 满血版成绩
| 基准测试集 (Benchmark) | 评估领域 / 任务 | DeepSeek-R1 (纯RL) | OpenAI o1-mini | Claude 3.5 Sonnet |
|---|---|---|---|---|
| MATH-500 | 高难度竞赛数学推导 | 97.3% [前沿第一] | 90.0% | 78.3% |
| AIME 2024 | 美国数学邀请赛真实题 | 79.8% | 63.6% | 39.2% |
| Codeforces | 算法与高难度竞技编程 | Rating 2029 (Top 3.7%) | Rating 1820 | Rating 1650 |
| GPQA Diamond | 博士级专业科学答题 | 71.5% | 60.0% | 65.0% |
| MMLU-Pro | 跨学科综合逻辑测试 | 84.0% | 80.3% | 78.9% |
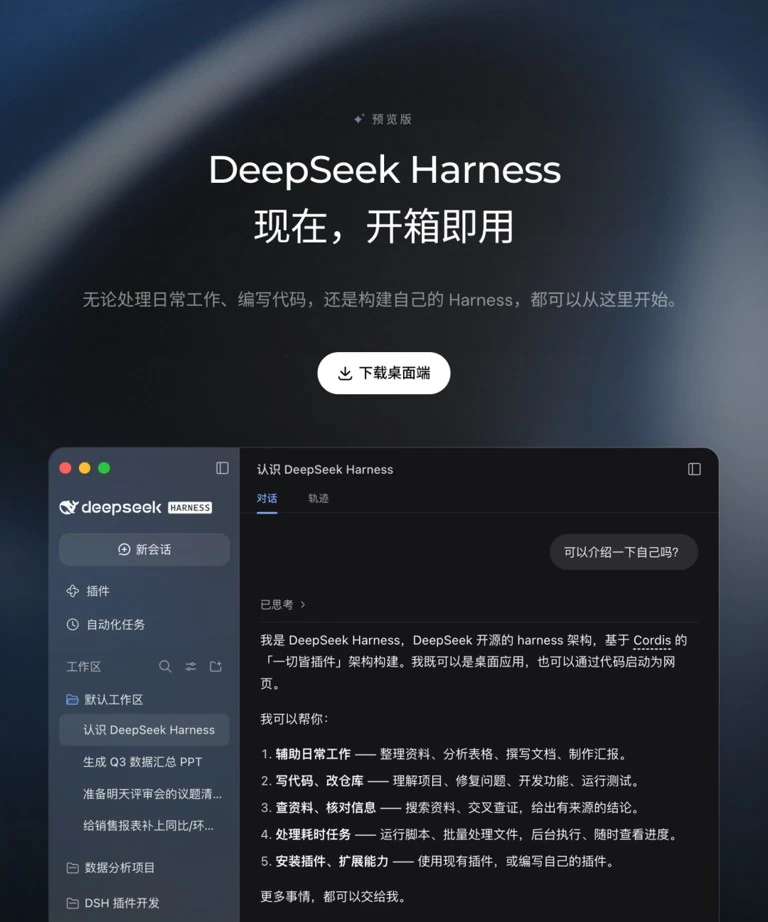
* 所有测试均通过 DeepSeek Harness 官方评测框架进行严格复现。
核心技术架构 · 黑板要点速记
✎ 晨光下写就的三大关键工程突破
NOTE.01 // MLA
多头潜在注意力
大幅压缩 KV 缓存显存占用,使极致长文档上下文的高速自省与实时推演成为可能。
NOTE.02 // MOE
细粒度混合专家
高达 671B 密集模型容量,每次仅激活 37B 参数,实现算力消耗与强劲性能的平衡。
NOTE.03 // HARNESS
DeepSeek Harness
全透明的自动化基准评测生态,让全球开发者能够独立复现和检验大模型真实水平。